


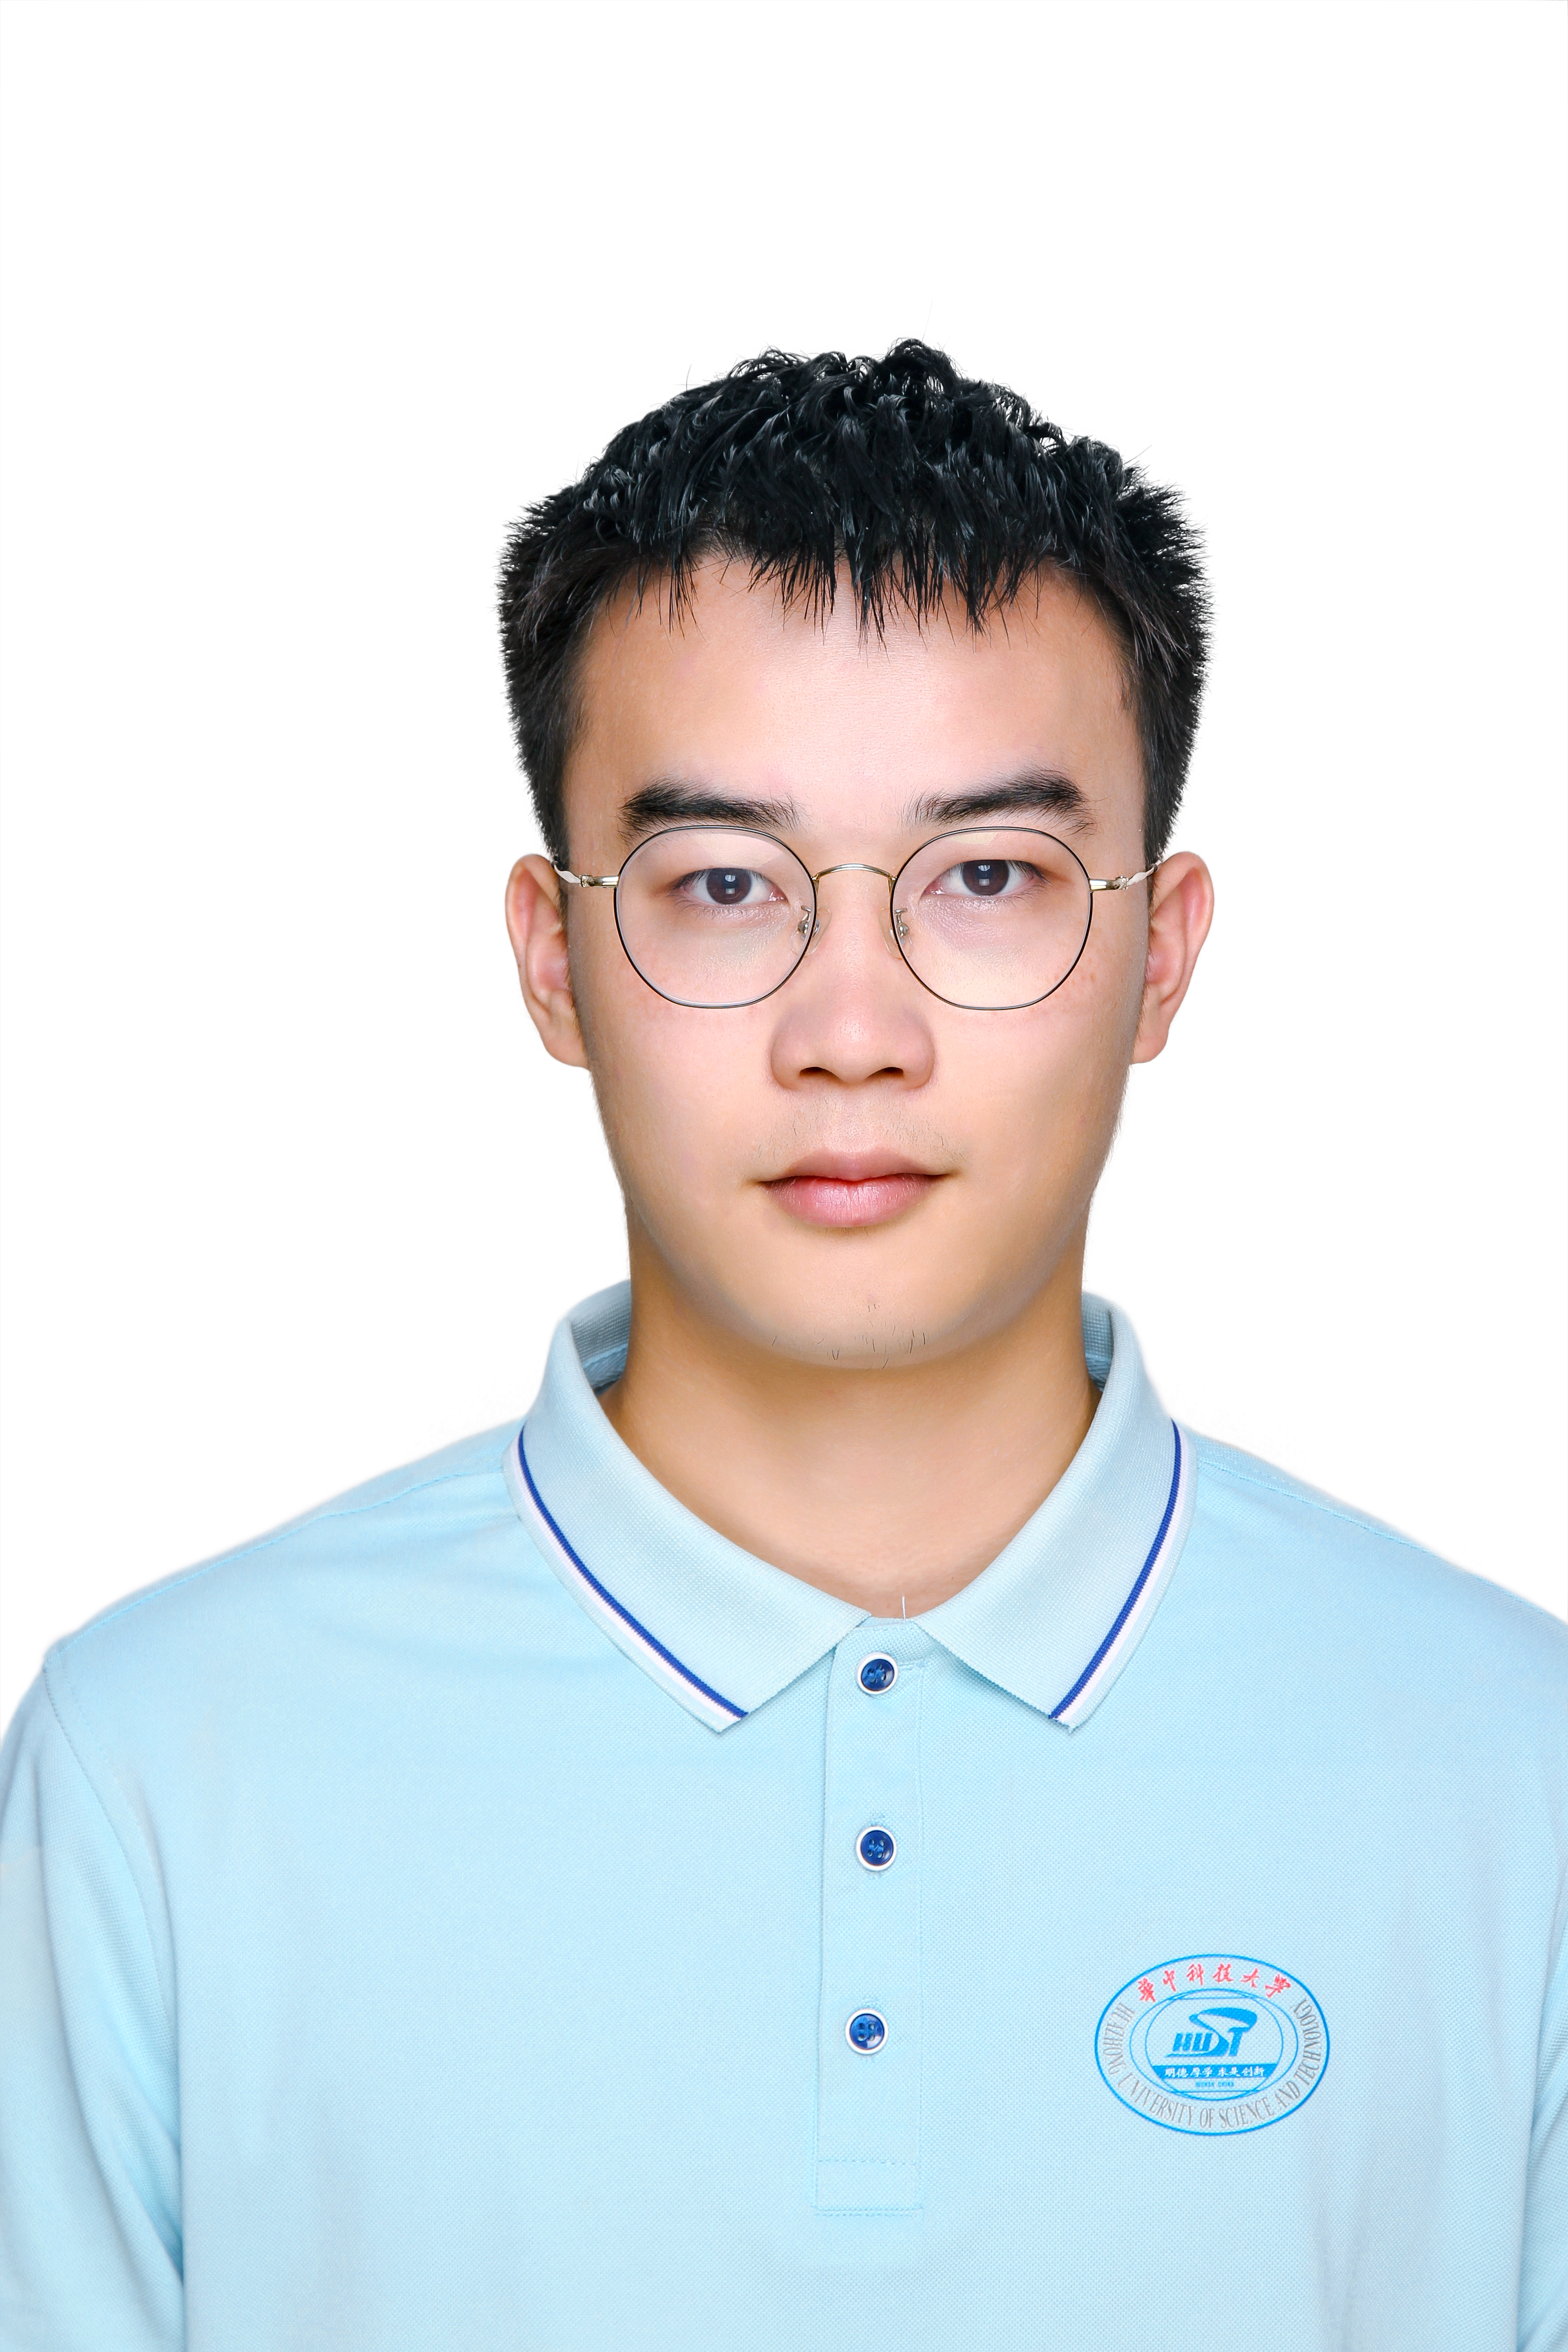
曹佳豪 - Cao Jiahao
教育背景
华中科技大学(985)· 软件工程(A+ 学科)· 视觉与特征学习实验室 · 硕士(保研)
2024.09 – 2027.06
- 导师:白翔(杰青、IEEE Fellow)
- 研究方向:多模态大模型、AIGC、计算机视觉、AI 应用开发
华中科技大学(985)· 智能建造(计算机辅修学位)· 卓越工程师计划实验班 · 本科
2020.09 – 2024.06
- 综测排名:5/82
- 荣誉奖项:华中科技大学本科特优生(占比约 3%)、科技创新一等奖学金、学习优秀奖学金等
实习经历
图灵人工智能研究院(南京)· 视觉算法工程师
2026.06 – 至今
通用工业缺陷检测大模型
核心技术栈:多模态 VLM / LoRA 微调 / vLLM 部署
- 项目背景:传统工业质检方案需逐产品单独训练模型,泛化差、迭代成本高。基于 Qwen3.5-4B VLM 大模型,构建覆盖鞋类、服装、PCB 等 7 个工业领域的通用缺陷检测系统,用一套基座 + 多域 LoRA 实现跨领域复用和高效部署。
- 训练流程:
- 数据层:整合归一化 7 类工业数据集,统一标注格式,设计 bbox 坐标归一化至 [0,1000] 的标准化管线。
- SFT 阶段:设计三阶段渐进训练——Stage1 仅学习边界框定位,Stage2 引入缺陷分类,Stage3 注入领域缺陷先验(如服装领域的”勾丝、油污、起球”等),逐步增加任务复杂度。
- DPO 阶段:构建误检抑制、漏检抑制、定位质量三类偏好对,通过 DPO 进一步优化模型的缺陷判断边界。
- 工程部署:基于 vLLM 实现单卡多 LoRA 常驻,通过权重原地加减法实现请求级毫秒热切换(<10ms),7 个适配器共约 500MB 常驻显存;设计分块推理 + 聚合 + NMS 的完整后处理流水线,提升小目标检测能力。
- 性能效果:微调后各领域检测精度显著提升——金属领域 mIoU 从基座 0.11 提升至 0.50(+4.4×),医疗器械 Precision 达 70.6%;7 个领域共享基座模型,切换延迟 <10ms,单张推理 1-2s,满足产线实时检测需求。
基于 SAM 的泡沫检测与绵密度量化系统
核心技术栈:视觉基础模型 / PEFT
- 项目背景:面向日化行业泡沫质量评估需求,基于 SAM3.1(约 850M)视觉大模型,构建端到端自动评估系统(手臂分割 → 泡沫实例分割 → 绵密度量化),替代传统人工打分评估。
- LoRA 参数高效微调:针对小样本数据集(500 张标注样本)场景,对 ViT Backbone、DETR Encoder/Decoder、Mask Decoder 注入 LoRA(rank=16),可训参数仅约 11M(占基座 1.3%);设计在线增强管线(翻折/旋转/裁剪/色彩抖动),泡沫分割 F1@0.50 较零样本提升约 18%,有效缓解小样本过拟合。
- 多因子绵密度量化:设计三因子融合评分模型——几何因子(覆盖率+填充率)、光度因子(泡沫-皮肤亮度差+白度比例)、纹理因子(多尺度泡孔检测+泡孔密度/均匀性),加权融合输出 L1~L5 等级,与人工评级一致性 85%+。
项目 / 科研经历
面向水下场景理解的视觉特征增强 MLLM
多模态大模型 · 2024.11 – 2025.04
- 项目背景:面向水下低光、浑浊、偏色等退化场景,基于 LLaVA-1.5 / Qwen2.5-VL 构建多模态理解框架,覆盖粗/细粒度分类、检测、计数、指代定位、图像描述、VQA 等 8 类任务,支持图像/区域/目标级的统一指令交互。
- 数据工程:整合公开水下数据集,构建约 15.8 万张图像、145 万组图文 QA 指令数据;针对检测、分类等任务设计规则模板生成,开放语言标签引入 MLLM 生成,结合质量筛选与人工复核流程,提升数据覆盖度与问答一致性。
- 核心方法:基于水下成像模型将退化拆解为后向散射干扰 + 吸收衰减;通过最低平均 RGB patch 定位暗 token,利用交叉注意力估计散射响应,结合深度特征预测吸收权重,在特征空间恢复退化视觉信息。
- 训练结果:4 卡 A800-80GB 联合训练 LoRA(rank=128)+ vision-language 投影层 + 视觉特征增强模块;相对 baseline(通用 MLLM),实现分类 +5.6%、Grounding PR@0.5 +4.3 等性能提升,在低光、偏色等退化子集上增益稳定。
基于 FLUX 的多视角同步生成图像系统
多模态生成 / 扩散模型 · 2026.01 – 2026.04
- 项目背景:针对通用文生图模型在多视角生成中容易出现主体身份漂移、局部细节错位等问题,基于 FLUX.1-dev(4B)搭建多视角同步生成系统,利用 UE 渲染得到的多视角数据进行训练。
- 多视角同步建模:在 FLUX Transformer 中插入轻量级多视角同步模块,将不同视角的 image tokens 重组为多视角特征表示,融合 12 维相机外参与视角位置编码,建立跨视角 token 级信息交互,实现 N-view 间全局语义与局部细节联合建模。
- 稳定训练策略:冻结 FLUX.1-dev 主干参数,单卡 4090-48G 训练新增模块;采用残差分支零初始化、间隔式插入同步层和单视角复制训练策略,使模型训练初期接近原始输出,再逐步学习跨视角信息交互对齐能力。
- 实验与效果验证:跨视角匹配点数量提升约 1.6×,跨视角 CLIP 相似度提升 5%–8%;CLIP-T 基本保持稳定,FID 增幅控制在 10% 以内;多图间局部细节更加一致。
专业能力
- 熟练掌握 Python、C/C++ 等语言及 swift、transformers、diffusers、ollama、LangChain 等 AI 领域常用框架。
- 深刻理解多模态对齐、大模型后训练、参数微调、模型部署等 AI 核心原理,具备 AIGC/多模态相关项目实践经验。
- 熟练使用 Claude Code、Codex、Cursor 等 AI 辅助开发工具,长期关注 AI 智能体、具身智能、RL 等前沿方向。
竞赛经历
-
第十八届”挑战杯”揭榜挂帅专项赛 城市排水管道智能作业机器人系统研究 —— 总决赛擂主(2023.09) - “华为杯”第二十二届中国研究生数学建模竞赛 —— 全国二等奖(2025.09)
联系 & 赞赏


如果您觉得我的工作对您有所帮助,愿意请我喝杯奶茶,请扫码打赏;也欢迎随时联系我!